
Cloud ou appareil local ? Pourquoi les applications d’IA utilisent-elles les deux ?
Date: 24 septembre 2026
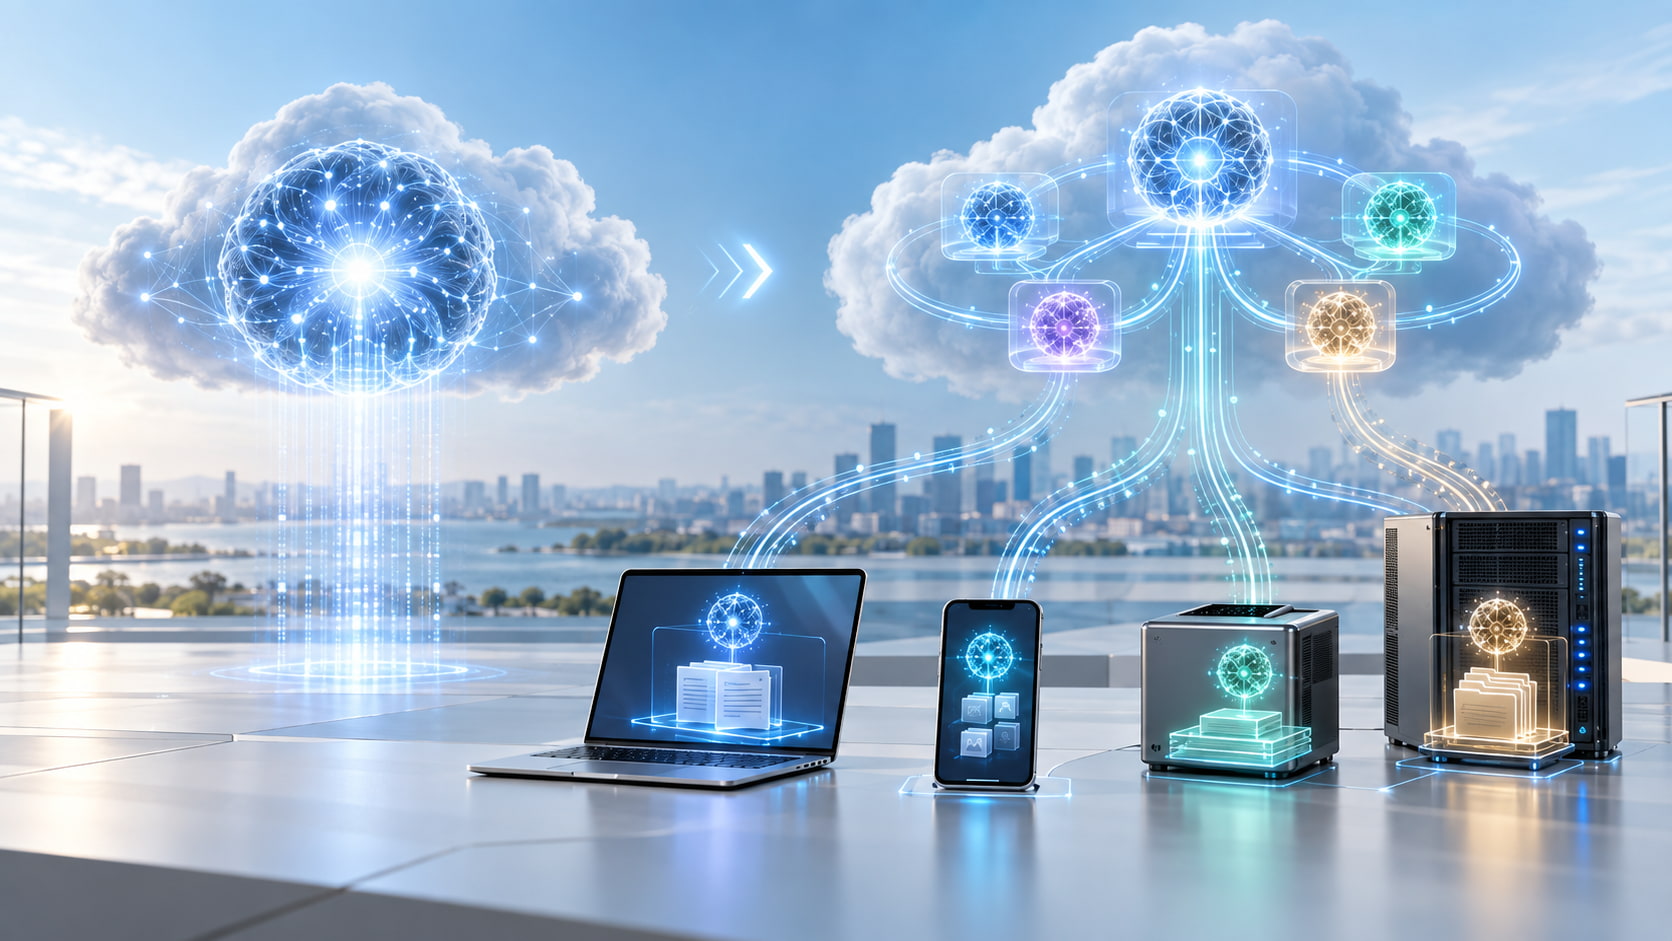
Pendant des années, les applications d’Intelligence Artificielle se sont principalement appuyées sur le cloud. Les données sont envoyées vers un serveur distant, le modèle les traite et la réponse est renvoyée à l’application ou à l’utilisateur.
Ce modèle offre une puissance de traitement élevée et donne accès à des modèles avancés, mais il ne constitue pas toujours la solution la plus adaptée. Certains processus impliquent du code privé, des documents internes ou des données sensibles qu’une organisation peut ne pas souhaiter envoyer en dehors de son infrastructure.
Dans d’autres cas, l’utilisation continue du cloud peut augmenter les coûts, ralentir les temps de réponse ou rendre l’application dépendante d’une connexion Internet.
C’est pourquoi une autre approche se développe : l’architecture hybride de l’IA. Dans ce modèle, une partie du processus se déroule dans le cloud, tandis que l’autre est exécutée localement sur un ordinateur, un téléphone, un serveur privé ou un autre appareil.
L’objectif n’est pas de choisir entre le cloud et l’appareil local. L’objectif est que chaque tâche soit exécutée là où cela est le plus pertinent.
Le cloud et le modèle local ont des rôles différents
Un modèle cloud peut disposer de capacités de raisonnement plus étendues, d’une fenêtre contextuelle plus importante et d’un accès à de puissantes ressources de traitement. Il peut analyser le problème, établir le plan et définir les étapes que le système doit suivre.
Un modèle local, en revanche, peut exécuter les tâches directement liées aux données privées ou à l’environnement de l’utilisateur. Il peut analyser des fichiers, examiner du code, préparer des modifications et utiliser les ressources de l’appareil sans envoyer l’ensemble des données vers le cloud.
Google a intégré cette répartition dans l’Antigravity SDK, permettant l’utilisation de modèles locaux pour des processus hors ligne. Dans l’architecture présentée, le modèle cloud peut servir de planificateur, tandis que les modèles locaux réalisent les tâches nécessitant de grandes quantités de données, comme l’examen et la modification du code directement sur l’appareil.
Cela crée un système dans lequel le modèle le plus puissant n’a pas besoin d’exécuter chaque action, tandis que le modèle local n’a pas besoin de comprendre seul l’ensemble du processus.
La planification peut se dérouler dans le cloud tandis que le travail est effectué sur l’appareil
Prenons l’exemple d’une entreprise qui souhaite examiner un projet logiciel afin d’identifier d’éventuels problèmes de sécurité.
Un modèle cloud peut recevoir une description générale du projet et préparer un plan d’examen. Il peut déterminer quelles parties doivent être analysées, quels types de problèmes doivent être recherchés et comment les résultats doivent être évalués.
Il n’est pas nécessaire d’envoyer l’intégralité du code dans le cloud.
Le modèle local peut utiliser le plan pour analyser les fichiers présents sur l’appareil ou au sein de l’infrastructure de l’entreprise. Il peut identifier les parties problématiques, proposer des modifications et exécuter des tests.
À la fin, seul un résumé contrôlé du résultat peut être envoyé dans le cloud, sans exposer l’intégralité du code privé.
Cette répartition du processus cherche à associer les capacités de raisonnement des modèles cloud au contrôle et à la confidentialité de l’exécution locale.
La confidentialité devient une composante de l’architecture
Dans un système entièrement fondé sur le cloud, les données doivent quitter l’appareil pour être traitées. Même lorsque la communication est protégée, l’organisation doit déterminer quelles données peuvent être envoyées et lesquelles doivent rester dans son environnement.
L’architecture hybride de l’IA aborde cette question dès la conception du système.
Les documents internes, le code source, les données personnelles ou les informations confidentielles peuvent être traités localement. Seules les instructions, les données anonymisées ou les informations dont le partage a été autorisé peuvent être envoyées dans le cloud.
Cela ne signifie pas que l’exécution locale est automatiquement sécurisée. Les modèles locaux doivent être administrés, mis à jour et surveillés. L’accès aux fichiers et l’utilisation des outils doivent être limités selon le rôle de l’application.
Toutefois, le traitement local donne aux organisations davantage de contrôle sur l’emplacement et la circulation de leurs données.
La rapidité ne dépend plus toujours d’Internet
Lorsque chaque demande est envoyée dans le cloud, le temps de réponse est influencé par la connexion Internet, la distance avec le serveur et la charge du service.
Un modèle local peut fournir des réponses plus rapides pour des tâches limitées, car les données n’ont pas besoin d’être envoyées vers un serveur externe avant de revenir sur l’appareil.
Cela est utile pour des processus tels que :
- L’analyse de documents sur l’appareil
- L’examen du code pendant le développement
- Le traitement de commandes courtes
- La classification des données
- La détection d’anomalies
- Le fonctionnement avec une connexion Internet limitée
- L’automatisation de processus internes
Le cloud peut être utilisé uniquement lorsque la tâche nécessite un raisonnement plus avancé, un contexte plus large ou des ressources dont l’appareil local ne dispose pas.
L’architecture hybride peut également avoir un effet sur les coûts
L’utilisation des modèles cloud est généralement liée au nombre de requêtes, à la quantité de données traitées et à la complexit